Какие IT-риски угрожают бизнесу и как их снизить с помощью аутсорсинга
Типичное утро в отделе продаж или логистики: сотрудники приходят на рабочие места, включают компьютеры и обнаруживают, что не загружается база 1С, отсутствует доступ к файловому серверу, а IP-телефония молчит. Клиенты не могут дозвониться, менеджеры не выставляют счета, склад заморозил отгрузки. При этом никакой масштабной хакерской атаки или стихийного бедствия не происходило — причина оказывается до ужаса банальной: на сервере вышел из строя один из накопителей, а регулярное резервное копирование не проводилось уже полгода.
В представлении многих руководителей IT-риски компании ассоциируются исключительно с громкими новостями о взломах, утечках данных и действиях вымогателей. Однако на практике наибольшие финансовые и операционные потери малый и средний бизнес несёт из-за повседневных, «незаметных» сбоев. Отказавший сетевой коммутатор, неудачно установившееся обновление ПО, увольнение единственного системного администратора, забрасывание инфраструктуры до первого инцидента — всё это реальные угрозы для IT-инфраструктуры, способные парализовать работу всей организации.
IT-риск — это вероятность возникновения сбоя в работе информационных систем, которая приводит к убыткам, простоям или репутационному ущербу. В этом материале подробно разберём, какие бывают IT-риски у современного бизнеса, почему они часто выявляются слишком поздно и как системный подход к обслуживанию инфраструктуры позволяет сделать их управляемыми.
Какие IT-риски существуют у бизнеса
Чтобы выстроить надёжную защиту, необходимо понимать природу возможных угроз. Основные риски IT-инфраструктуры можно разделить на пять ключевых категорий.
1. Технические риски
К этой группе относятся проблемы, связанные со сбоем аппаратной части и базового программного обеспечения:
- отказ серверов — выход из строя блоков питания, материнских плат, RAID-контроллеров или дисковых накопителей;
- поломка рабочих станций — выход из строя компьютеров ключевых сотрудников (бухгалтера, руководителя отдела продаж);
- неисправность сетевого оборудования — сбои в работе роутеров, управляемых коммутаторов и точек доступа Wi-Fi;
- перегрузка инфраструктуры — нехватка вычислительных мощностей или оперативной памяти при росте нагрузки на системы;
- использование морально устаревшей техники — оборудование, исчерпавшее свой ресурс, подвержено внезапным отказам гораздо больше, чем новые системы.
2. Риски простоя (Operational Downtime)
Простой — это прямое следствие технического сбоя, выраженное в остановке бизнес-процессов. Цепочка всегда одинакова: сбой IT-системы → невозможность выполнения функционала сотрудниками → приостановка взаимодействия с клиентами → прямые финансовые убытки.
Примеры типичных сценариев простоя:
- сбой в 1С: бухгалтерия не может провести платежи, а склад — принять или отгрузить товар;
- недоступность общих папок и хранилищ: сотрудники теряют доступ к коммерческим предложениям, договорам и рабочей документации;
- отказ телефонии и АТС: компания теряет входящие обращения клиентов и заказы;
- прекращение работы сайта или интернет-магазина: останавливается приём онлайн-заказов;
- сбой канала связи: отсутствие доступа в интернет блокирует работу всех облачных сервисов и удалённых филиалов.

3. Риски потери данных
Потеря критически важной информации (клиентской базы, первичной бухгалтерии, интеллектуальной собственности) часто обходится бизнесу дороже, чем замена вышедшего из строя оборудования. К утрате данных приводят:
- случайное или намеренное удаление файлов сотрудниками;
- физическая поломка накопителей (HDD/SSD);
- повреждение структур баз данных вследствие нештатного выключения питания;
- заражение систем вирусами, в том числе шифровальщиками;
- отсутствие автоматизированного резервного копирования или его неправильная настройка.
Важно: наличие настроенного резервного копирования само по себе не гарантирует сохранность информации. Если регулярное тестовое восстановление данных из бэкапа не проводится, в критический момент копии могут оказаться повреждёнными или неполными.

4. Риски информационной безопасности
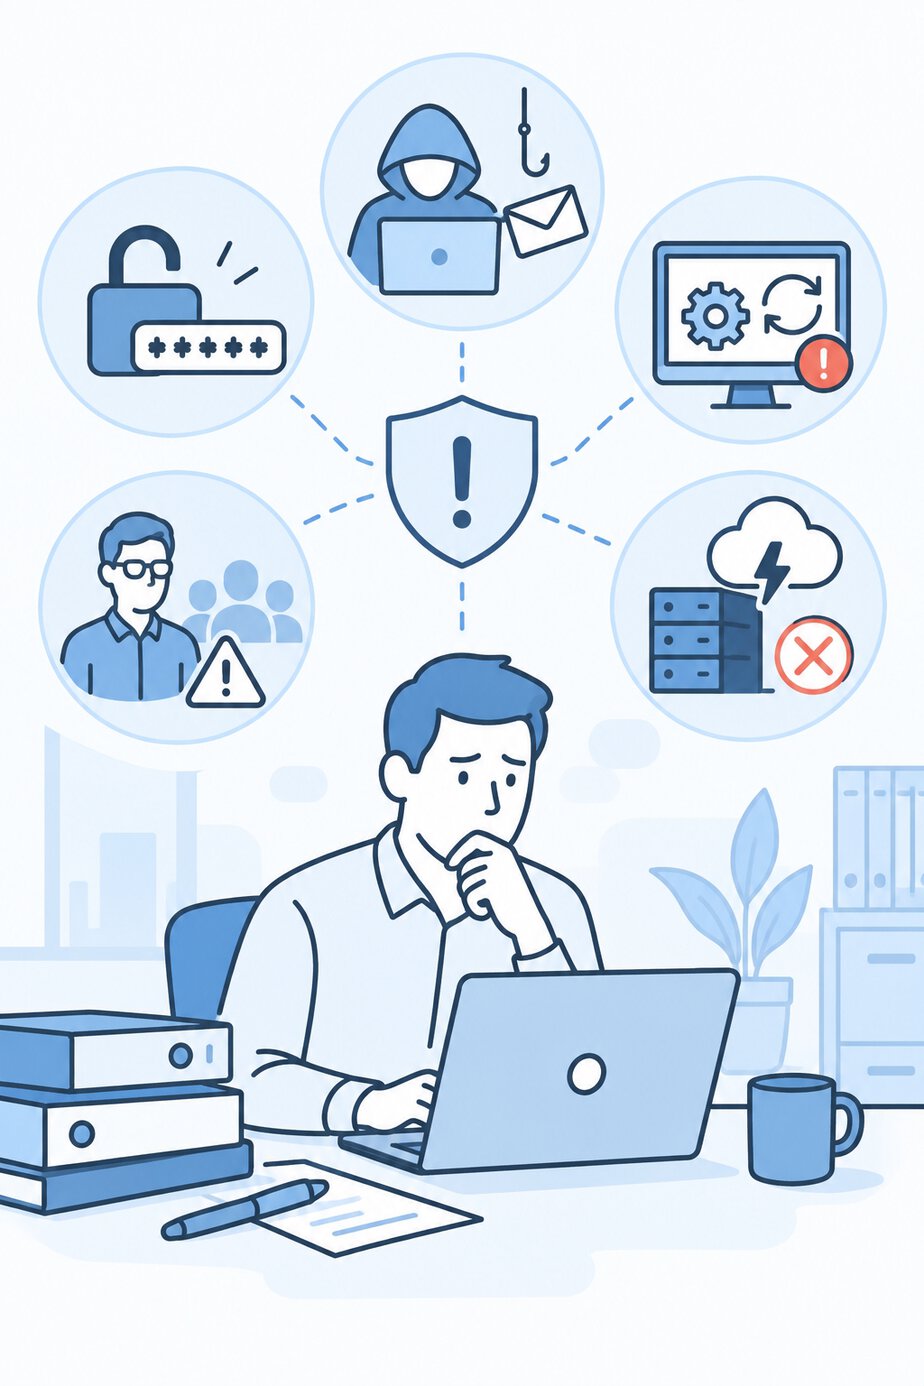
Угрозы информационной безопасности касаются как внешних атак, так и внутренних уязвимостей:
- слабая парольная политика — использование простых комбинаций символов (‘123456’, ‘qwerty’ и т.п.) или одинаковых паролей для разных сервисов;
- избыточные права доступа — ситуация, когда рядовые сотрудники имеют доступ к конфиденциальным финансовым или управленческим документам;
- отсутствие обновлений — использование операционных систем и программ с неисправленными уязвимостями;
- фишинг и вредоносное ПО — попадание вирусов в локальную сеть через почтовые вложения или сторонние носители;
- незащищённые каналы связи — подключение к корпоративным ресурсам из дома или публичных сетей без использования защищённых VPN-туннелей;
- человеческий фактор при увольнении — сохранение активных учётных записей и доступов у бывших сотрудников.
5. Организационные IT-риски
Один из самых распространённых блоков угроз для малого и среднего бизнеса, обусловленный отсутствием регламентов и системного управления:
- зависимость от одного специалиста — все пароли, схемы сети и настройки хранятся в голове у одного системного администратора, и при его болезни, увольнении или недоступности компания оказывается заложником ситуации;
- отсутствие технической документации — отсутствие схем СКС, кабельных трасс, списков учётных записей и карт инфраструктуры;
- отсутствие учёта активов — руководство не располагает точной информацией о количестве имеющейся техники, её состоянии и используемых лицензиях ПО;
- отсутствие плана Disaster Recovery (DR, «аварийное восстановление») — в компании нет прописанного порядка действий на случай масштабных аварий или выхода из строя ключевых узлов.
Почему IT-риски часто обнаруживаются слишком поздно
В большинстве компаний малого и среднего сегмента управление IT-инфраструктурой строится по модели «ремонтируем только то, что сломалось».
Главные причины, по которым проблемы выявляются уже на этапе катастрофы:
- Отсутствие профилактических работ — регулярная проверка дисковых массивов, очистка оборудования от пыли, анализ логов ошибок и проверка обновлений воспринимаются как необязательные процессы.
- Использование оборудования «до последнего» — серверы и ПК эксплуатируются без плановой замены до полного физического выхода из строя.
- Отсутствие систем автоматического мониторинга — о проблемах с перегревом, заполнением диска или сбоем службы администратор узнает не из уведомления системы, а из звонка растерянного или рассерженного пользователя.
- Формальный подход к бэкапам — резервное копирование настраивается один раз при запуске сервера, после чего его актуальность и целостность годами никто не проверяет.
- Скрытый накопительный эффект — незначительные ошибки в настройках сети, накопление дубликатов баз данных, устаревание ПО годами не проявляют себя, пока совокупность факторов не приводит к каскадному сбою.
Главная проблема многих компаний — не отсутствие IT-систем как таковых, а отсутствие системного контроля и регулярного аудита их состояния.
Как IT-аутсорсинг помогает управлять рисками
Заменять реактивный подход на превентивный позволяет передача задач по поддержке инфраструктуры специализированному подрядчику. Внедрив системный подход, бизнес получает возможность выявлять уязвимые места до того, как они превратятся в аварии. Посмотрим, за счёт каких механизмов это достигается.
Регулярное обслуживание вместо устранения аварий
Превентивное обслуживание строится на плановых регламентных работах. Систематическая диагностика компьютеров, серверов и сетевого оборудования позволяет зафиксировать деградацию компонентов (например, появление битых секторов на жёстком диске или сбои в оперативной памяти) задолго до окончательного отказа техники.
Плановое обновление программного обеспечения, оптимизация операционных систем и чистка аппаратной части снижают количество внезапных сбоев на рабочих местах пользователей. Для компании это означает возможность планировать расходы на IT и избегать внезапной остановки работы отделов.
Для контроля состояния техники и поддержания её работоспособности привлекается комплексное регулярное обслуживание компьютеров.
Мониторинг серверов и критических систем
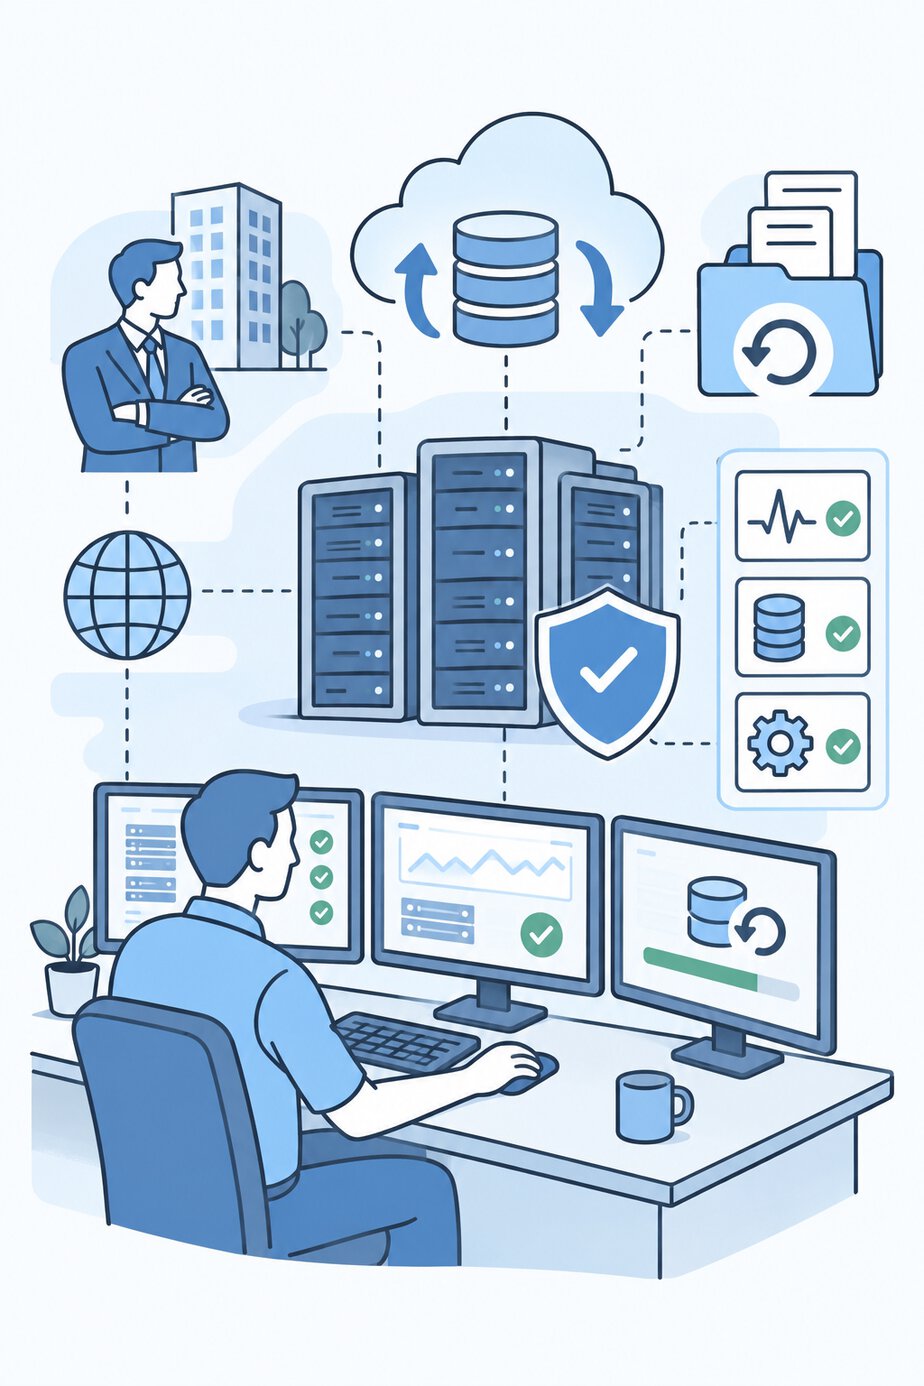
В отличие от ручной проверки, автоматизированные системы мониторинга отслеживают метрики инфраструктуры в режиме 24/7. Мониторинг фиксирует:
- критический рост нагрузки на процессор и оперативную память;
- остаток свободного места на дисковых накопителях;
- температуру компонентов серверов;
- статус работы ключевых служб и сервисов (1С, СУБД, веб-сервер, почта);
- доступность сетевых узлов и внешних каналов связи.
Инженер получает уведомление об отклонении от нормы на ранней стадии — например, когда диск заполнен на 90%, а не когда база данных оставилась из-за нехватки места. Это даёт время устранить проблему без простоя бизнес-сервисов.
Выстроить такой контроль помогает специализированное обслуживание серверов.
Резервное копирование и правильное восстановление данных
Надёжная стратегия защиты данных опирается на правило «3–2–1»: иметь как минимум три копии данных, хранить их на двух разных типах носителей и одну копию держать на удалённой площадке (в облаке или изолированном сервере).
Профессиональный подход к бэкапам включает:
- чёткое определение критичных данных (базы 1С, файловые архивы, почта, конфигурации сетевых устройств);
- разделение копий (резервные копии не должны храниться на том же физическом диске или сервере, где находятся оригиналы);
- автоматизацию и шифрование копий;
- регулярное тестовое восстановление (RTO/RPO) — проверку того, за какое время и насколько корректно данные могут быть подняты из архива при полной утрате оригинала.
Организовать надёжное хранение информации можно, используя выделенный сервер хранения данных.

IT-аудит: поиск слабых мест до возникновения аварий
Перед тем как брать инфраструктуру под контроль, необходимо составить её полную карту и определить накопленные проблемы. Для этого проводится первичная диагностика.
Профессиональный IT-аудит позволяет объективно оценить:
- физическое состояние оборудования и сетевых линий;
- корректность настройки серверов и сетевых экранов;
- уровень защищённости периметра сети от внешних проникновений;
- распределение прав доступа сотрудников к корпоративной информации;
- актуальность используемого ПО и наличие лицензий;
- реальное состояние системы резервного копирования.
Результатом аудита становится подробный отчёт с перечнем обнаруженных уязвимостей и приоритетным планом их устранения.
Какие IT-риски можно снизить с помощью регулярной поддержки
В таблице ниже мы сопоставили типичные риски для бизнеса, их потенциальные последствия и системные меры, применяемые в рамках регулярного IT-обслуживания.
| IT-риск | Возможные последствия для бизнеса | Как снижается риск регулярным IT-обслуживанием |
| Отказ сервера | Остановка работы ключевых отделов, недоступность баз данных, финансовые убытки. | Круглосуточный мониторинг параметров, плановая профилактика компонентов, резервирование узлов. |
| Потеря данных | Безвозвратная утрата финансовой отчётности, баз клиентов и документов. | Автоматическое резервное копирование по правилу «3–2–1», регламентные проверки восстановления. |
| Сбой локальной сети / Wi-Fi | Недоступность внутренних ресурсов, отсутствие интернета, обрыв связи. | Диагностика коммутаторов, оптимизация сетевых настроек, обслуживание локальных сетей. |
| Заражение вредоносным ПО | Шифрование файлов, утечка конфиденциальной информации, сбои ПК. | Централизованное обновление антивирусов, закрытие неиспользуемых портов, разграничение прав. |
| Ошибки сотрудников | Случайное удаление папок, повреждение записей в справочниках 1С. | Строгое разграничение прав доступа, регулярное создание точек восстановления и бэкапов. |
| Устаревшее оборудование | Частые незапланированные сбои, медленная работа программ, провалы в производительности. | IT-аудит, плановая модернизация (апгрейд), составление графика обновления парка техники. |
| Сбой телефонии / АТС | Потеря входящих звонков от клиентов, срыв сделок и снижении качества сервиса. | Регулярная проверка конфигураций, контроль каналов связи, обслуживание АТС и телефонии. |
| Остановка 1С | Замораживание продаж, невозможность выписки первичных документов и отгрузок. | Администрирование серверов 1С, оптимизация баз данных, регламентное обслуживание. |
Аутсорсинг или штатный IT-специалист: что влияет на уровень риска
При организации IT-поддержки перед руководством всегда встаёт выбор: нанять системного администратора в штат или привлечь профильного подрядчика. Оба формата имеют свои особенности, которые напрямую влияют на итоговый уровень рисков.

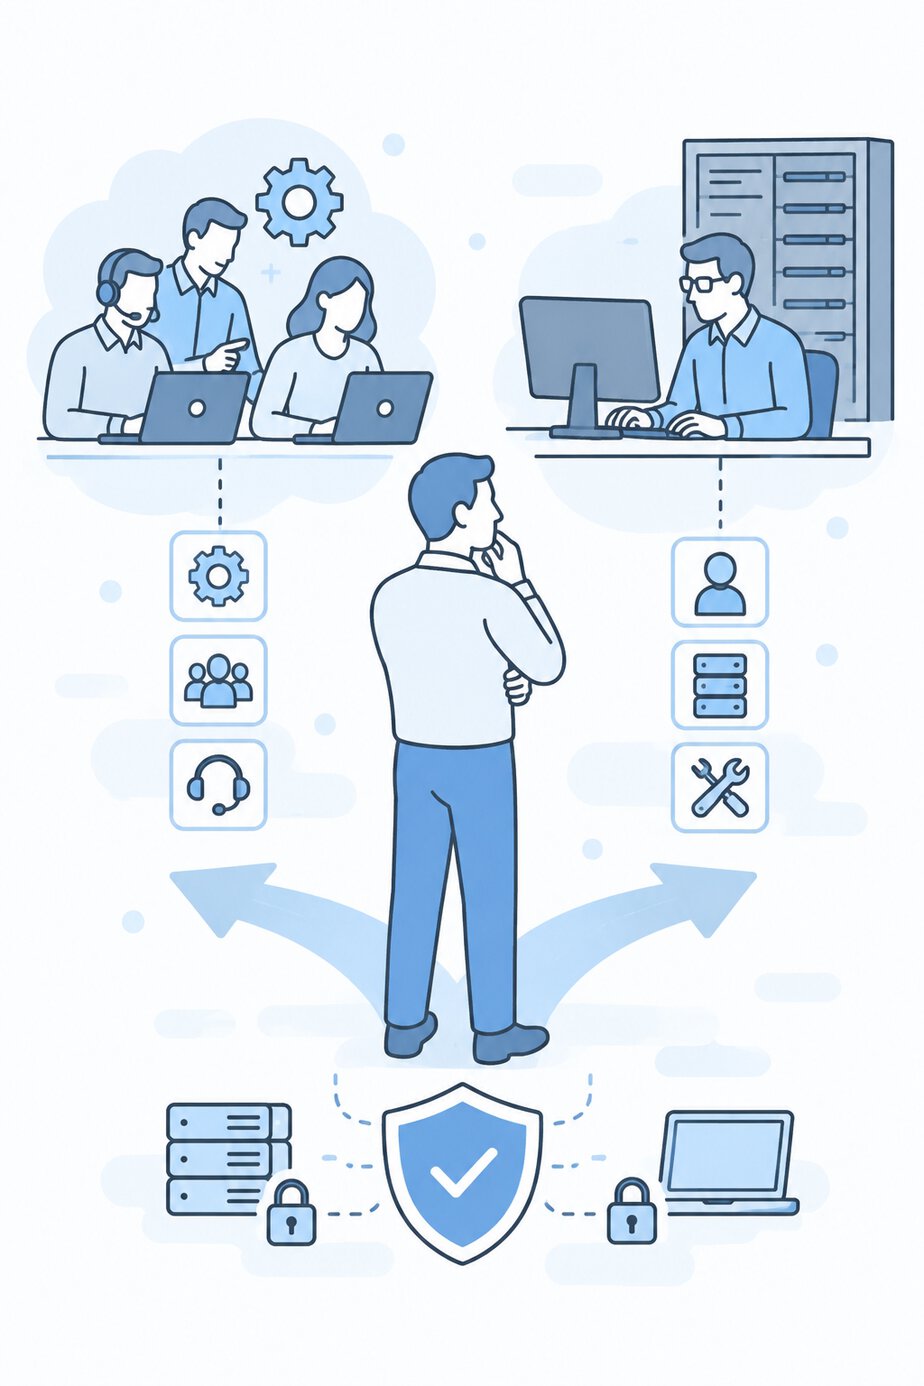
Штатный системный администратор
Преимущества:
- постоянно находится в офисе и может физически подойти к компьютеру сотрудника за пару минут;
- хорошо понимает специфику внутренних неформальных процессов компании.
Факторы риска:
- человеческий фактор — администратор может заболеть, уйти в отпуск или уволиться в самый неподходящий момент;
- ограниченность компетенций — один человек не может быть одинаково глубоким экспертом в администрировании Linux/Windows, настройке маршрутизаторов Cisco, безопасности, базах данных SQL, поддержке 1С и монтаже СКС;
- отсутствие внешнего контроля — руководству сложно оценить качество работы и обоснованность решений единственного IT-специалиста.
IT-аутсорсинг
Преимущества:
- командная экспертиза — к решению задач привлекается целая команда узкопрофильных инженеров (сетевики, системные администраторы, специалисты по безопасности, 1С-разработчики);
- непрерывность обслуживания — подрядчик обеспечивает поддержку без перерывов на отпуска и болезни благодаря взаимозаменяемости сотрудников;
- финансовая и юридическая ответственность — параметры работы, скорость реакции и время устранения неисправностей фиксируются в соглашении об уровне обслуживания — SLA (Service Level Agreement).
Ограничения:
- качество сервиса полностью зависит от выбора подрядчика и чёткости формулировок договора;
- требуется первичная формализация процессов и согласование регламентов взаимодействия.
Качественный IT-аутсорсинг не отменяет необходимости присутствия инженеров на объекте при возникновении аппаратно-технических проблем, однако смещает акцент на превентивный дистанционный контроль и автоматизацию.
Как выбрать IT-подрядчика с точки зрения управления рисками
Чтобы сотрудничество с внешним сервисом снижало, а не создавало новые риски, перед подписанием договора стоит проверить кандидата по нескольким критериям:
- Наличие и параметры SLA — прописаны ли в договоре конкретные временные рамки реакции на заявки разных типов (критический сбой, стандартная задача, консультация)?
- Классификация инцидентов — чётко ли определено, что именно считается критическим сбоем (например, остановка сервера 1С или недоступность сети целиком)?
- Зоны ответственности — указано ли в соглашении, кто отвечает за регулярность создания и целостность резервных копий?
- Тестирование восстановления — входит ли в обязанности подрядчика периодическая проверка разворачивания бэкапов?
- Система мониторинга — использует ли компания собственное ПО для непрерывного отслеживания состояния оборудования клиента?
- Ведение документации — обязуется ли подрядчик вести и актуализировать карту IT-инфраструктуры, схемы сети и регламенты?
- Выездное обслуживание — есть ли возможность оперативного выезда инженера на объект при авариях, которые нельзя решить удалённо?
- Комплексность компетенций — закрывает ли команда задачи по серверам, сетям, телефонии, 1С и физической безопасности?
- Конфиденциальность и безопасность — подписывается ли соглашение о неразглашении (NDA) и как регламентируется доступ сотрудников подрядчика к коммерческим данным клиента?
Грамотно организованное ИТ-обслуживание бизнеса обязательно включает прозрачные критерии оценки качества работы и регламентированный порядок действий при любых штатных и нештатных ситуациях.
Что сделать компании, чтобы снизить IT-риски уже сейчас
Для наведения базового порядка в инфраструктуре руководству и ответственным сотрудникам стоит выполнить следующий практический чек-лист:
- Составить реестр критичных IT-систем. Определить, остановка каких сервисов (1С, почта, телефония, сайт) может привести к немедленным финансовым потерям.
- Проверить наличие резервных копий. Убедиться, что бэкапы ключевых баз данных и файлов создаются автоматически и сохраняются на изолированный носитель.
- Провести тестовое восстановление. Попробовать развернуть копию базы 1С или файлового архива на тестовом ПК, чтобы убедиться в их работоспособности.
- Провести ревизию учётных записей. Проверить список пользователей в системах, удалить или заблокировать аккаунты уволенных сотрудников.
- Ограничить административные права. Убрать у рядовых пользователей права локальных администраторов на рабочих ПК, чтобы предотвратить несанкционированную установку сторонних программ.
- Проверить состояние обновлений. Убедиться, что на серверах и рабочих станциях установлены критические обновления безопасности ОС и антивирусных баз.
- Инвентаризировать технику. Составить список оборудования с указанием возраста компонентов, чтобы выявить кандидатов на скорую замену.
- Оценить состояние сети. Проверить качество работы сетевых кабелей, коммутаторов и беспроводных точек доступа в офисе.
- Назначить ответственных за инциденты. Зафиксировать, к кому конкретно сотрудники должны обращаться при появлении сбоев и кто принимает решения при авариях.
- Заказать профессиональный аудит. Если точное состояние инфраструктуры неизвестно, привлечь специалистов для независимой оценки рисков.
Когда компании особенно нужен системный IT-контроль
Обеспечение системной IT-поддержки становится жизненно необходимым при наступлении определённых этапов развития бизнеса:
- масштабирование и быстрый рост — открытие новых филиалов, складов или торговых точек, увеличение штата сотрудников;
- переход на удалённую или гибридную работу — появление множества подключений к корпоративным сервисам из внешних сетей;
- хаотично сформированная инфраструктура — оборудование закупалось фрагментарно разными людьми в разное время, документация отсутствует;
- учащение случаев сбоев — регулярные «подвисания» программ, проблемы с сетью или доступом к файлам стали привычной частью рабочего дня;
- внедрение новых масштабных систем — перенос ресурсов в облако, запуск ERP, переход на новые версии 1С или интеграция IP-АТС;
- рост ценности данных — компания накапливает персональные данные клиентов, коммерческую тайну или интеллектуальную собственность;
- нехватка ресурсов штатного специалиста — один системный администратор перестал справляться с потоком заявок пользователей и проведением плановых работ.
При наступлении этих событий комплексный подход позволяет избежать хаоса и предотвратить дорогостоящие простои.

Важно понимать: IT-аутсорсинг не является панацеей, которая с момента подписания договора автоматически устранит абсолютно все риски. Любая техника имеет свойство вырабатывать ресурс, а внешние каналы связи могут выходить из строя по вине провайдеров.
Однако задача системного IT-обслуживания заключается в другом — сделать риски предсказуемыми и управляемыми. Логика построения такой системы всегда последовательна:
IT-аудит → Выявление уязвимостей → Превентивная профилактика → Круглосуточный мониторинг → Настройка бэкапов → Внедрение регламентов → Быстрое реагирование
Когда бизнес не располагает собственным крупным IT-отделом или хочет передать непрофильные задачи специализированной инжиниринговой компании, выстроить эту цепочку помогает внешняя поддержка. Специалисты компании «БитРейд» осуществляют комплексный IT-аутсорсинг в Санкт-Петербурге и ЛО, помогая коммерческим организациям проверять и беречь ИТ-инфраструктуру, настраивать регулярное обслуживание и минимизировать риски простоя бизнес-процессов.